Jev 實測,不寫字的 AI 模型能分類、不能判斷
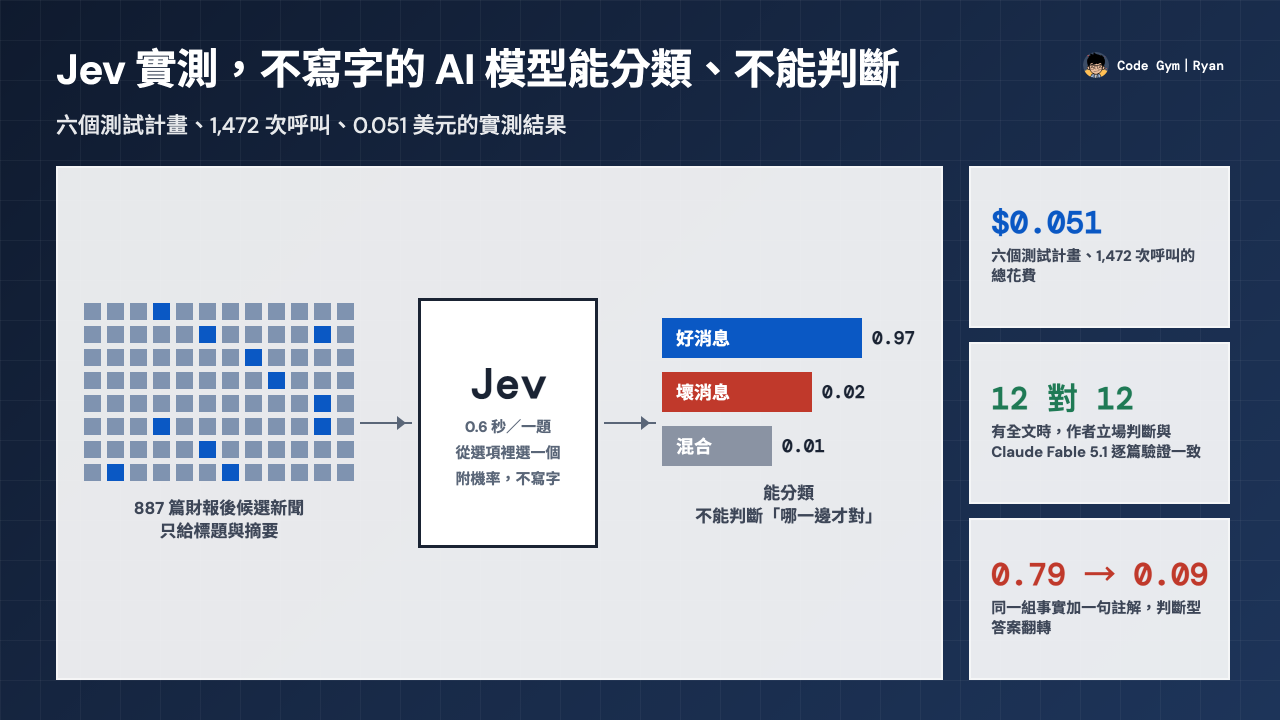
9 月 15 日,一個不會寫字的 AI 模型登上 Hacker News 榜首一整天,首日超過一千五百分、四百多則留言。它叫 Jev,做的事只有一件:你給它一段資料和幾個選項,它告訴你該選哪一個,附一個機率。它不會回答問題,不會寫摘要,也不會解釋為什麼。同一週,我們把它接進自己的財報分析流程,讓它讀了 887 篇財報新聞、61 條文件與媒體的衝突、14 段法說會問答,總共花了五分錢。
這篇文章回答三個問題:這個新的模型類別是什麼、它想解決什麼問題;它在我們的財報分析工作裡能做什麼、不能做什麼;以及它適合誰。前兩個問題有廠商與社群的說法,第二個問題我們有自己的數據。
一個不寫字的模型,想解決什麼問題?
Jev 的開發公司 TypeSafe AI 把它稱為第一個 System One 模型。名字來自心理學家 Daniel Kahneman 的「系統一與系統二」:系統一是快速、直覺的判斷,系統二是緩慢、逐步的推理。創辦人 Diogo Almeida 是 RLHF 與 InstructGPT 的共同發明人,他在官方發布文裡的問題是:模型在對話上已經超越人類好幾年,那自動化都到哪裡去了?
他的答案是,軟體裡絕大多數的「決策」其實是系統一判斷:這封信該分給哪個部門、這個請求緊不緊急、這筆操作危不危險、這篇內容屬於哪一類。過去三年,業界拿完整的大型語言模型做這些事,等於租一台會推理會寫文章的引擎,只用它回答一個是非題;每次要等幾秒、花幾分錢,還要解析它吐出來的文字。
📖 System One 模型:只回答型別化問題的 AI 模型。你送進去一段資料(文字或 JSON)和一組問題,每個問題有固定的答案形式,包括從選項中選一個(Choice)、在給定的等級上評分(Score)、回答是或否的機率(Noul);它回傳答案與機率分布,不產生任何自由文字。
所以 Jev 給出三個承諾。第一是速度,廠商說端到端 70 到 500 毫秒;我們從台灣打過去的中位數是 0.6 秒。第二是價格,每百萬 input token 0.042 美元,output 免費;我們 1,472 次呼叫合計 0.051 美元。第三是格式保證,它只能從你給的選項裡選,不會多寫一句,程式可以直接拿答案分支。
這個模型的名字也有含意。Jev 取自 19 世紀經濟學家 William Stanley Jevons,他觀察到蒸汽機提高了煤的使用效率之後,煤的總用量反而暴增。TypeSafe 的意思很直接:當一次判斷的成本降到接近零,軟體裡會出現大量過去不划算的判斷。
廠商說的 444 倍便宜與零幻覺,是怎麼算出來的?
官方首頁寫「193.6 倍快、444.6 倍便宜」。這個數字的來源是廠商自己的四組工作流程測試,共 711 個案例,而參考答案不是人工標記,是「GPT-6 Astra 與 Fable 5.1 兩個模型判斷的平均」。也就是說,廠商測的是「Jev 和最聰明的兩個模型平均起來有多像」,不是「Jev 對不對」。官方發布文自己列了限制:速度是在西岸的筆電上量的、價格可能有補貼、測試流程由公司內部的能力團隊挑選。這份誠實值得記一筆,但也代表這些數字目前沒有獨立驗證。
「零幻覺」是另一個要拆開看的說法。它的意思是格式上的保證:如果你給的選項是低、中、高,它不會回答「極高」。它仍然可以很有信心地選錯。Hacker News 上的討論集中在三點:延遲比較不對等,因為被拿來比的大模型是在做完整的推理;零幻覺是格式保證不是正確保證;沒有公開架構,也沒有上公開排行榜。執行長在討論串裡承認,模型有可能「很有信心地答錯」。
最有用的一份官方文件反而是弱點頁。TypeSafe 為每個版本公布一份「jaggedness」清單,列出這個版本做不好的事,9 月 17 日的版本列了九條:讀字面不讀意圖、不會算數也不會數數、日期當文字讀、多一層轉折就退化、資料太雜就失準、資料裡的內容會移動答案、指令互相矛盾時不會調和、不保證兩個答案彼此一致、不會產生文字。我們的測試撞到了其中六條,後面會逐一對上。
外部的獨立測試目前只有兩份小型的。一份 78 題的分類測試,Jev 得 0.974;一份 60 題的 AI agent 工具風險分類,得 91.7%,其中定義清楚的 34 題全對、定義模糊的 14 題只對 71.4%。兩份的樣本都太小,但第二份的形狀值得先記住:清楚的題全對,模糊的題掉到七成。
我們怎麼測?
我們的財報分析流程是一組固定的步驟:從美國證券交易委員會的申報文件取數、讀法說會逐字稿、在財報後的三天內抓媒體全文,把媒體的說法與文件對照,最後寫成報告。每一步都留下了結構化的產出:每篇新聞有立場與類型的標籤,每條文件與媒體的衝突有分類,每段法說會問答有「管理層有沒有正面回答」的判讀。這些既有的產出就是現成的標準答案。要先講清楚一件事:這條流程由 Claude 模型執行,前述的新聞標籤、衝突分類與法說會判讀是 Claude Opus 5 在 8 月底到 9 月中產出的;本次測試由 Claude Fable 5.1 主持,12 篇全文的逐篇驗證也由它完成。所以這篇文章比的是模型對模型:Jev 對 Claude Opus 5 的標籤、Jev 對 Claude Fable 5.1 的全文判讀,以及 Jev 對程式算出的真值。
測試分六個計畫,設計原則有三條。第一,只問可判定的題,答案能對到我們自己的標籤或程式算出來的真值。第二,每個計畫先估花費再送出,呼叫器內建累計上限。第三,餵給它的資料只放原始文本,不放我們的解讀,這一條後來證明是關鍵。六個計畫合計 1,472 次呼叫、104.8 萬 token、0.051 美元。
它會什麼?
先說做得好的。
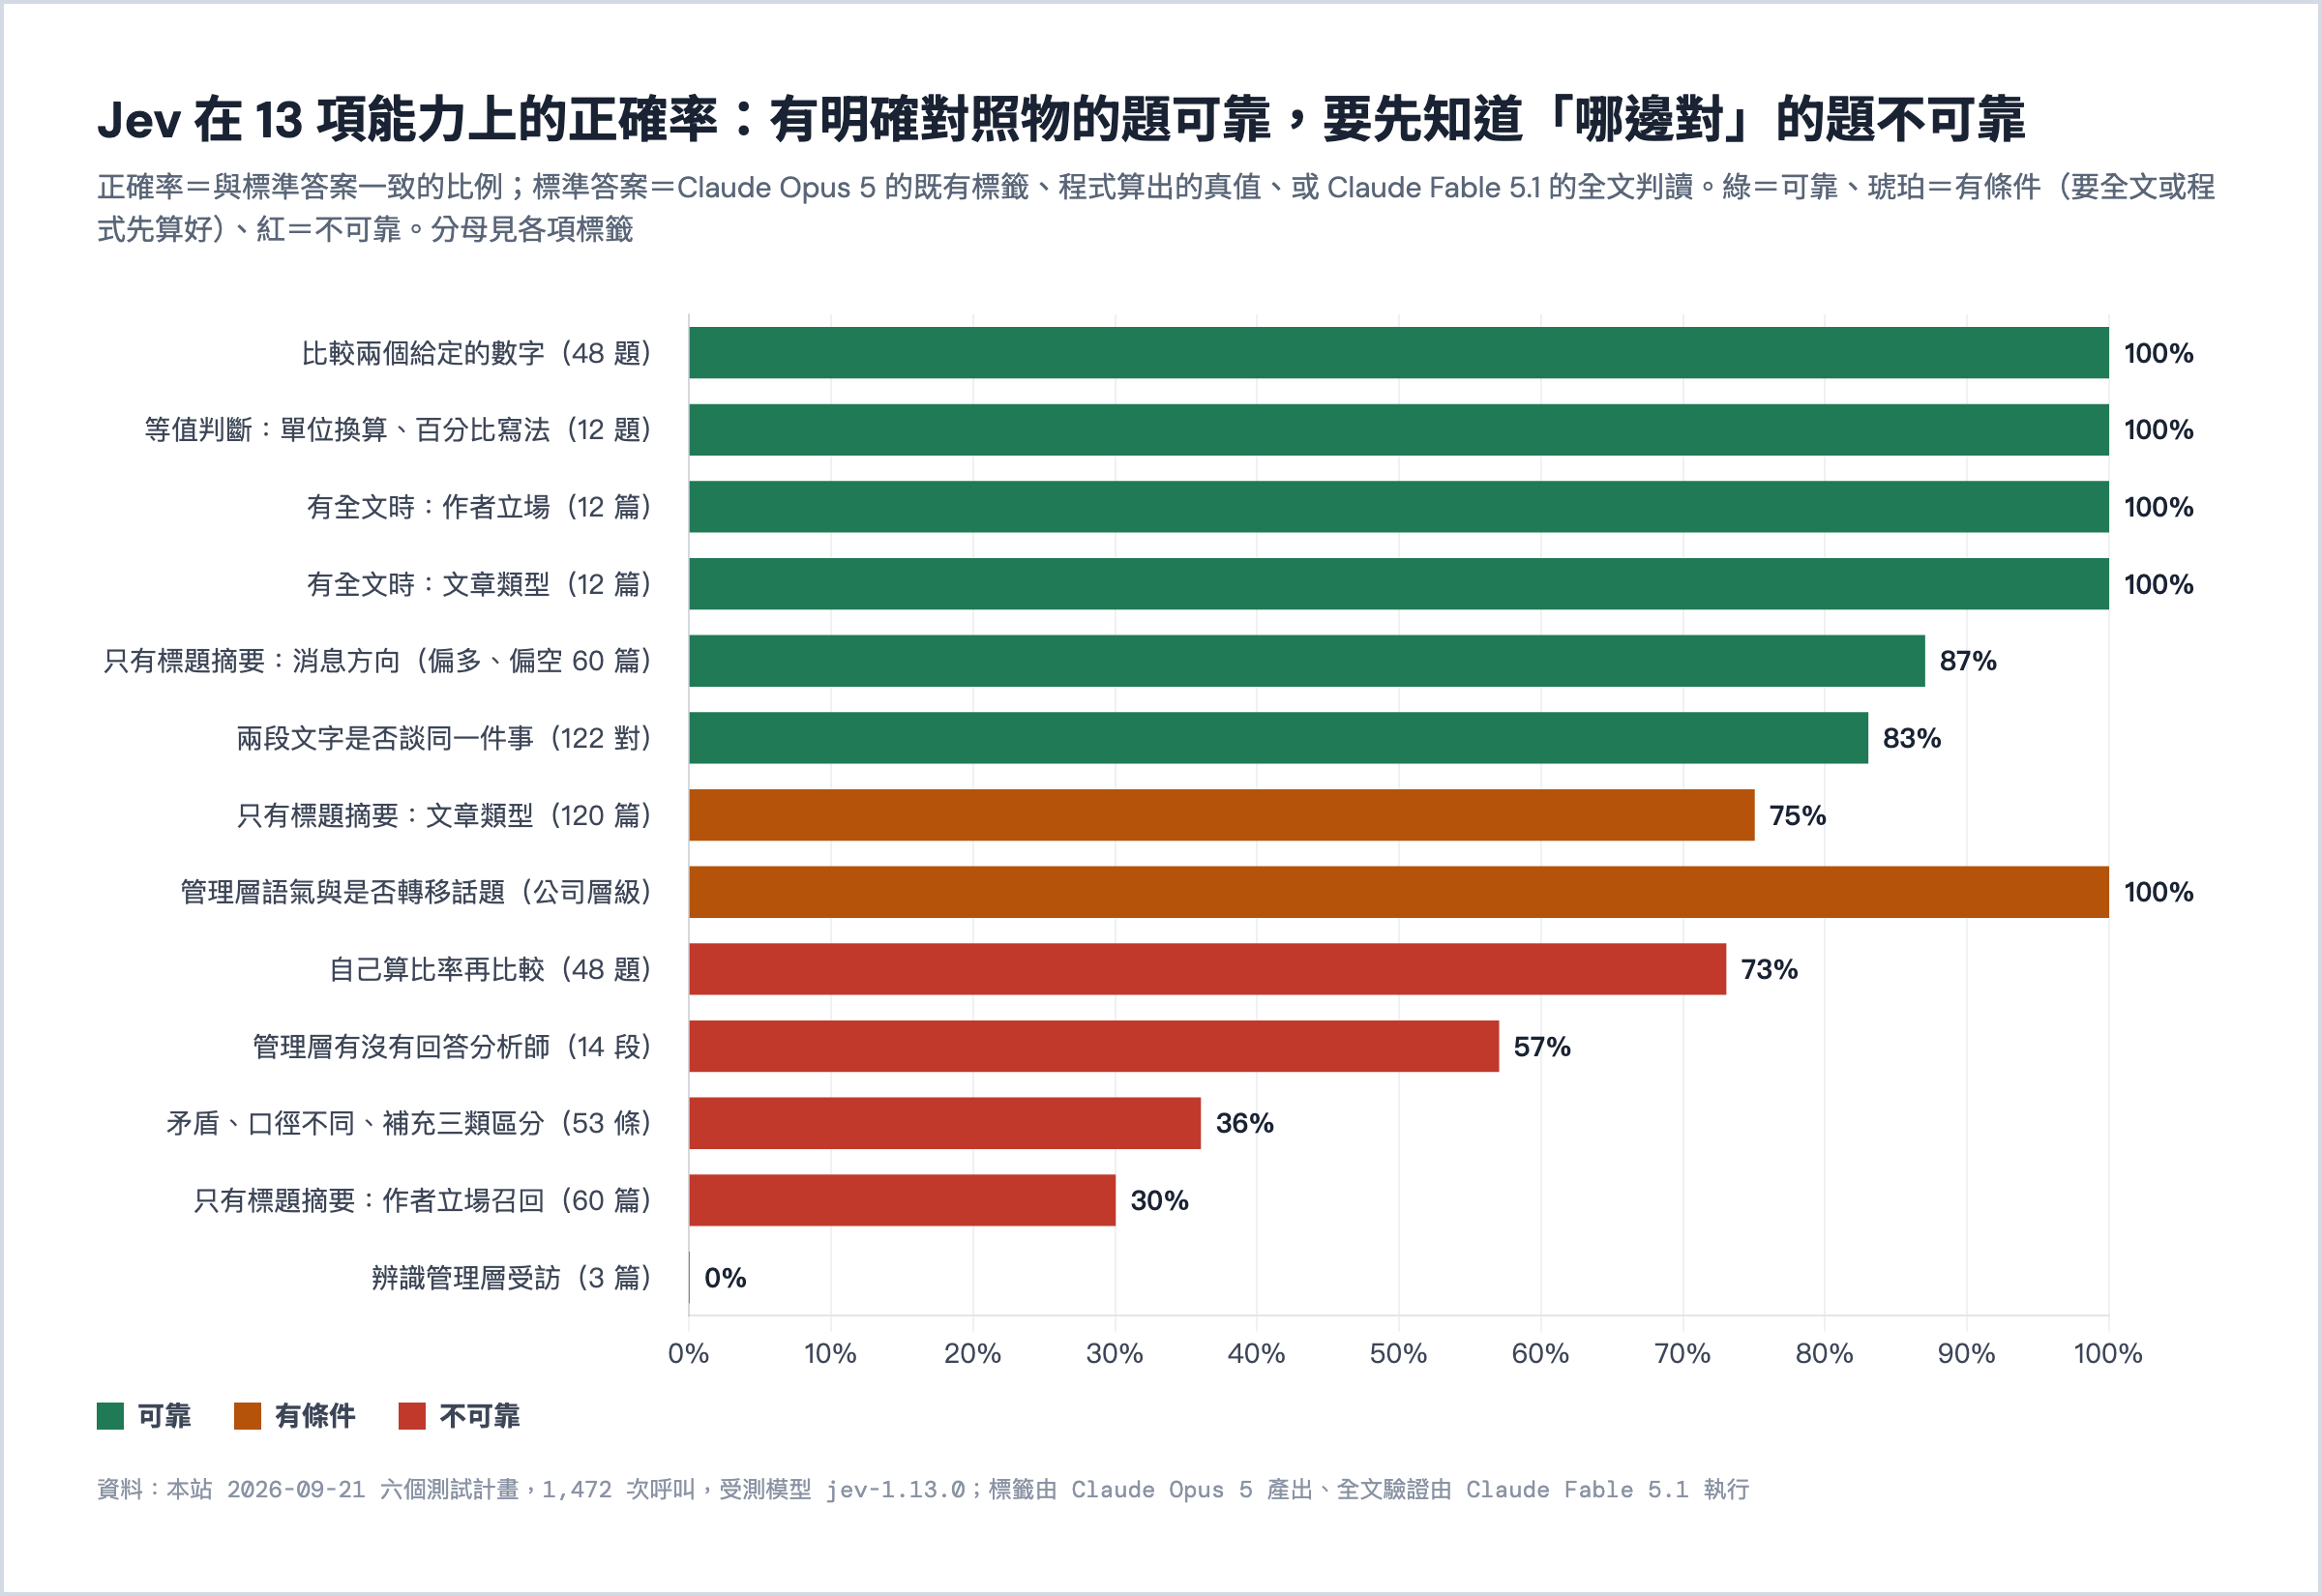
給定的兩個數字,它會比。 我們隨機生成 24 組兩期財務數字,問「本期營收高於去年同期嗎」「年增率超過 10% 嗎」,48 題全對。問兩種寫法是不是同一個數,例如 11,345 百萬與 11.3 十億、20.5% 與 0.205,12 題全對。其中一題我們預設的標準答案寫「2,331 百萬與 2,332 百萬相同」,它判不同,它是對的。
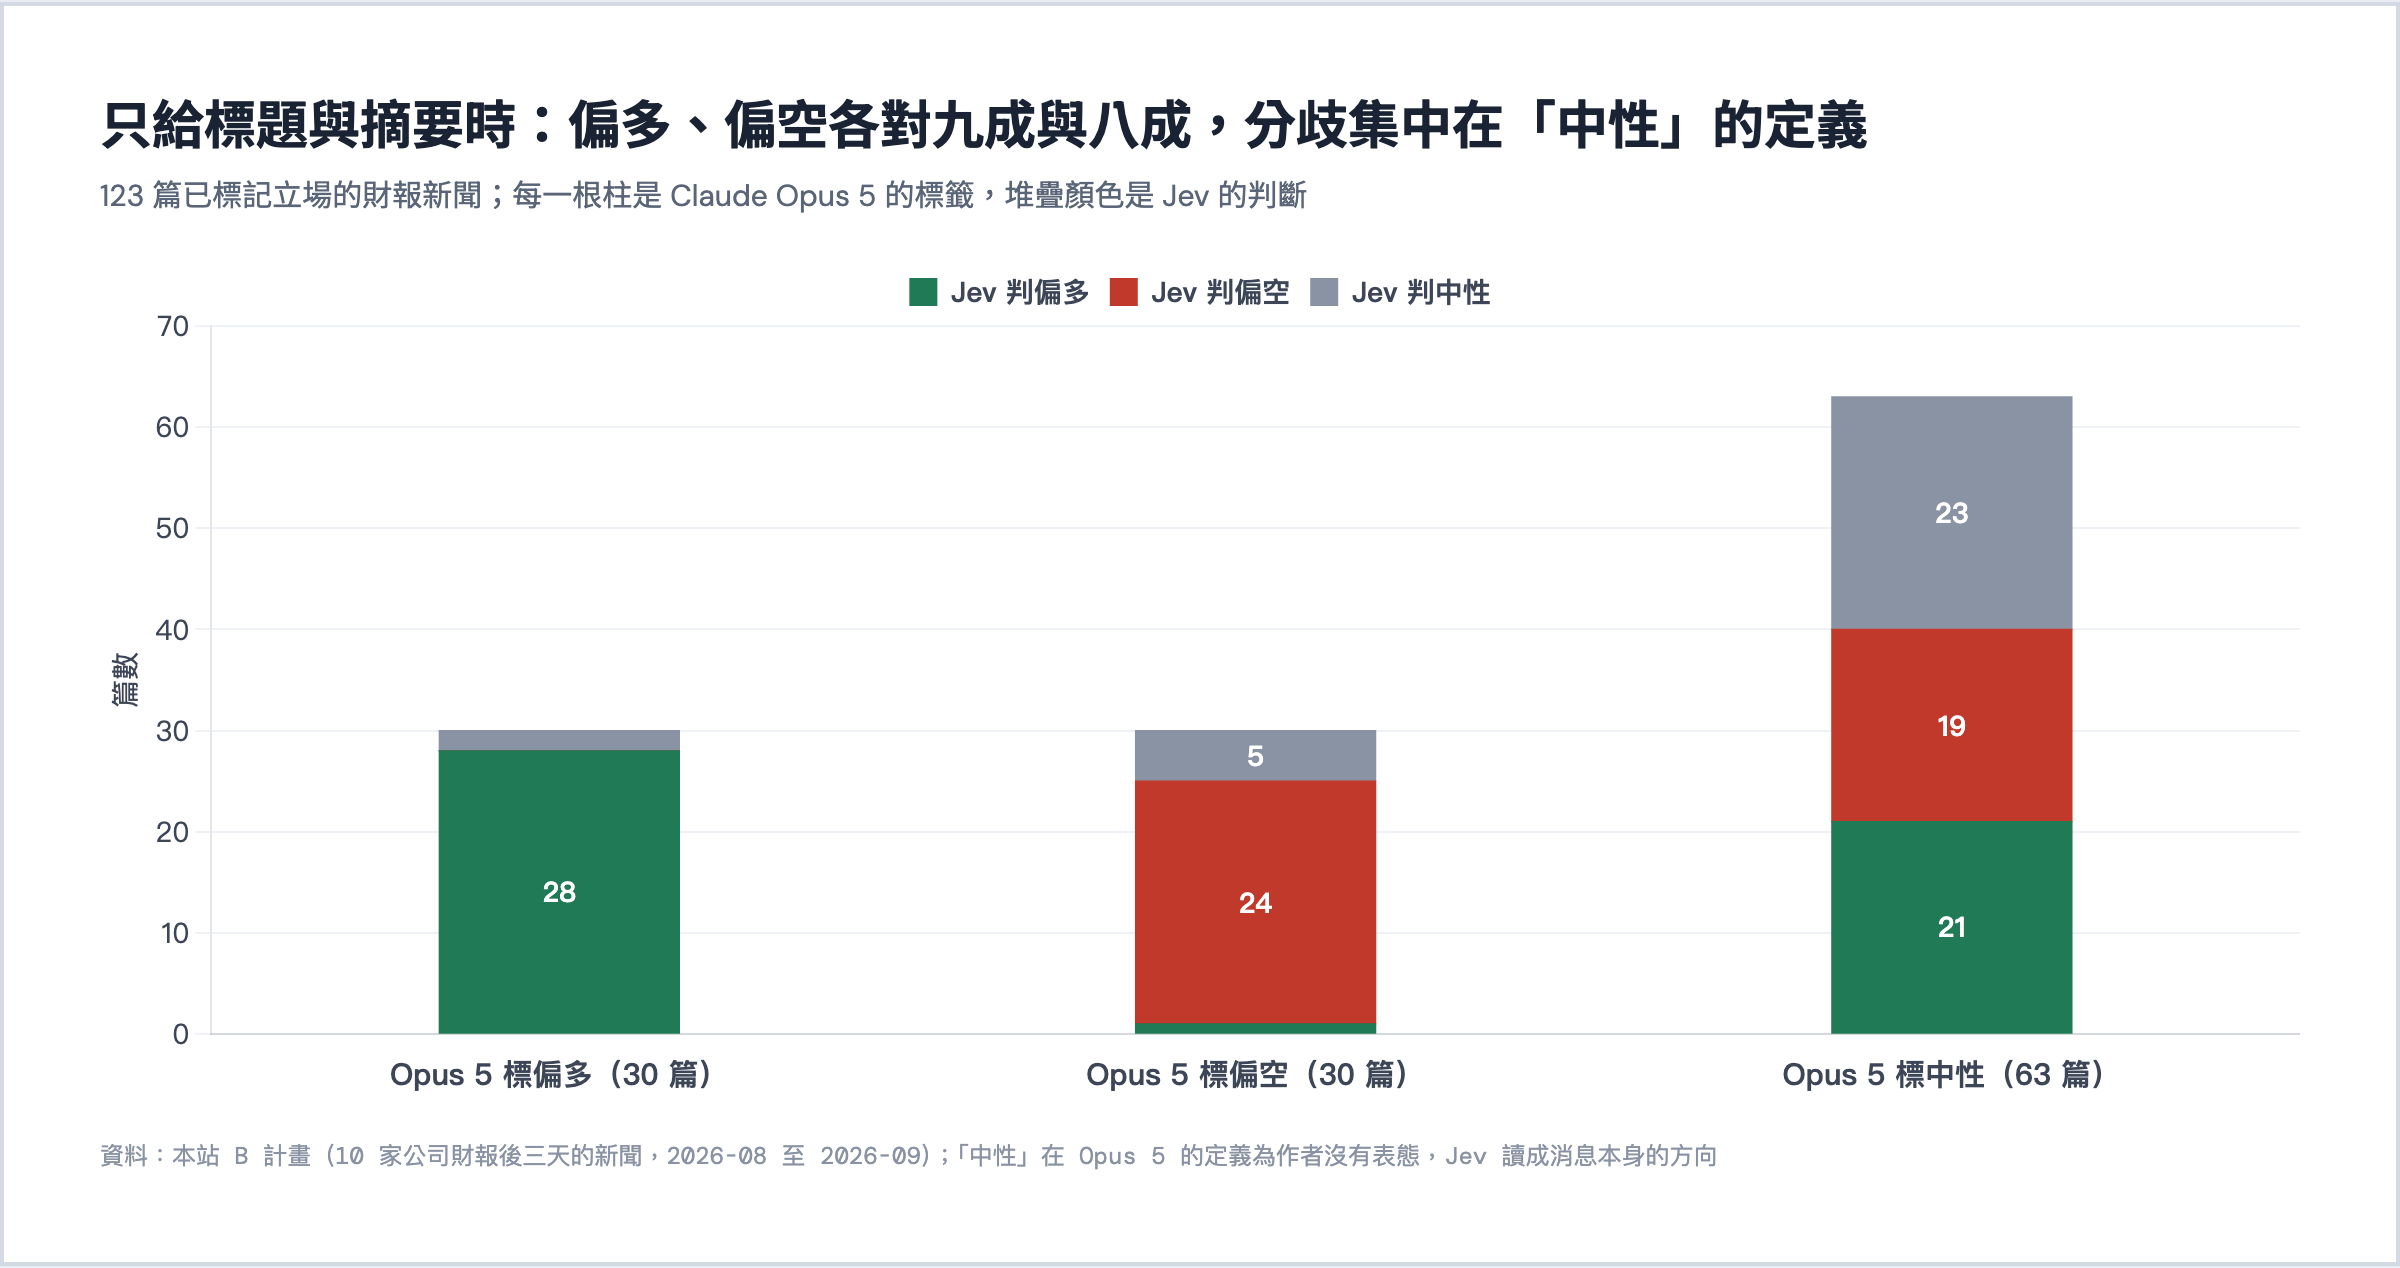
只有標題和摘要時,它判得出消息的好壞。 132 篇 Claude Opus 5 已標記立場的財報新聞,只給標題、站名與一段摘要,Opus 5 標偏多的 30 篇它對 28 篇,標偏空的 30 篇它對 24 篇。
有全文時,它判得出作者有沒有表態。 這是最重要的一組。我們挑了 12 篇先前分歧最大的文章,用瀏覽器抓回全文,問「作者自己有沒有對這檔股票表達方向性立場,不看被報導的消息好壞,也不看被引述的分析師怎麼說」。12 篇由 Claude Fable 5.1 逐篇讀完全文再判,它的 12 個答案與 Fable 5.1 的判讀全部一致。
它不會什麼?
再說做不到的,分界線只有一條。
要它自己算比率再比較,就不可靠。 同樣那 24 組數字,問「營業利益率有沒有擴大」,這需要它自己算兩個比率再比,24 題錯 5 題;問「營業利益成長是否快於營收」,錯 8 題。錯的全部集中在利潤率變動不到 1.2 個百分點的題,它的答案跟著營收成長的方向走。資料裡明給利潤率的 12 組,只錯 1 題。這對應弱點頁的「不會算數」。
判斷兩段話是矛盾、還是口徑不同,接近隨機。 本站有 61 條「文件說 X、媒體說 Y」的衝突,每條已由 Claude Opus 5 分好是真矛盾、口徑不同、還是媒體補充了文件沒說的事。Jev 對真矛盾的召回只有 43%,三類之間的區分接近亂猜。但同一批資料問「這兩句話談的是同一個事實嗎」,61 對真配對它認出 42 對,61 對故意亂配的它只誤認 2 對。它分得出兩段話有沒有關係,分不出關係是什麼。
判斷管理層有沒有回答分析師的問題,沒有鑑別力。 14 段法說會問答,Claude Opus 5 的法說會分析點名了 8 段是迴避或部分回答。Jev 把其中 12 段都判成「部分回答」,被點名的與沒被點名的平均分數幾乎相同。它可以分出「管理層給了數字」,分不出「給的是不是問到的數字」。
📖 校準機率與信心值:Jev 每個答案附機率分布,Choice 與 Score 另附一個信心值,代表機率集中在一個選項的程度。信心值反映的是「答案分布集不集中」,不是「答案對不對」;一個定義不清的問題可以得到 0.98 的信心與錯的答案。廠商的弱點頁與獨立測試者都提醒這兩個數字要分開看。
分界線是:題目有沒有明確的對照物。兩個數字、兩段文字、一整篇全文,有的話它答得可靠;要先知道「哪一邊的口徑才對」「答的是不是問的」,它答不了,因為那本身就是分析。
一句註解,為什麼能翻轉答案?
有一組實驗值得單獨講,因為它決定了這種模型只能吃什麼。
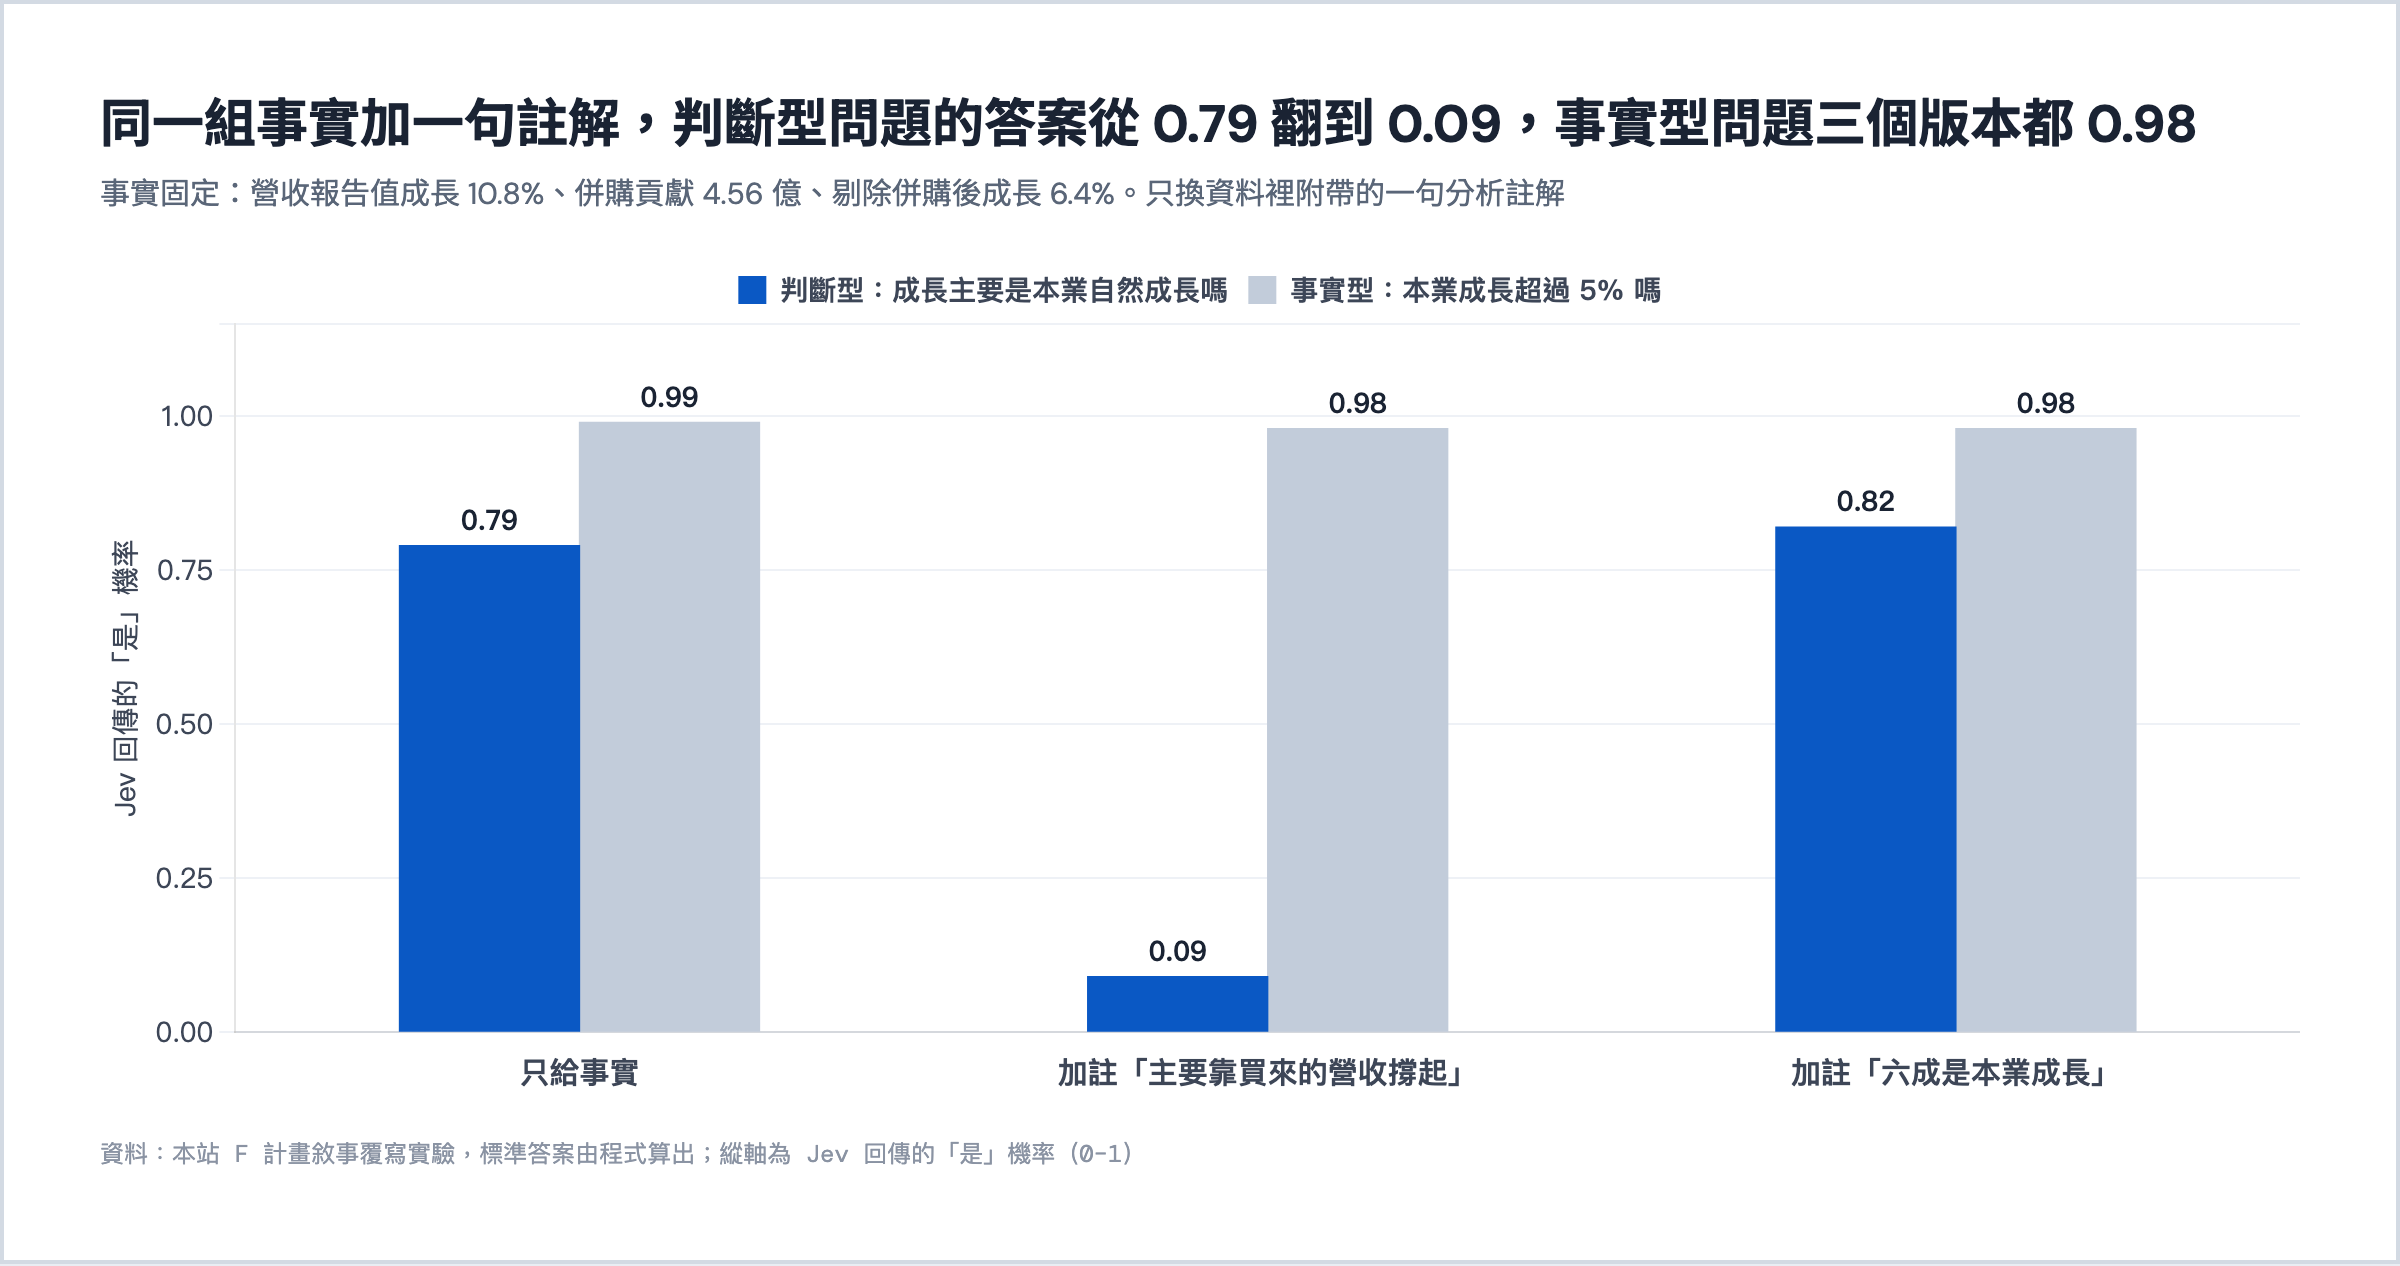
我們給它一組事實:營收報告值成長 10.8%、其中併購貢獻 4.56 億、剔除併購後的本業成長 6.4%。問「這一季的營收成長主要是本業自然成長嗎」,它答 0.79。同一組事實,加一句分析師註解「這一季的兩位數成長主要靠買來的營收撐起」,答案變成 0.09。換一句「六成是本業成長」,答案回到 0.82。但同一組事實問「本業成長有沒有超過 5%」,三個版本都是 0.98。
判斷型的問題被一句話翻轉,事實型的問題不動,因為後者有明確的數字可以對。弱點頁把這條寫成「資料裡的內容會移動答案」;我們的實驗補了一個更細的觀察,不需要惡意的內容,一句正常的分析註解就夠了,甚至我們自己從文章裡挑出來的原文引言也會把答案往引言的方向推。結論很實際:餵給它的資料只能放原始資料和程式算好的數字,不能放任何人的解讀。
它為什麼在財報分析裡幫助有限?
把上面的結果放回我們的工作,答案很清楚,而且和模型好壞無關。
財報分析的價值幾乎全部落在判斷型的問題:這個數字為什麼和去年不能直接比、媒體的說法哪裡與文件不一致、管理層回答的措辭比上一季強還是弱。以它現在的設計,這些它一項都碰不到,因為它不產生文字、不做推理;版本更新能改善的是弱點頁上那幾條,改不了這個設計取捨。它能做的是事實型的分流:這篇新聞是好消息還是壞消息、這兩段話有沒有講同一件事。
更根本的是工作的形狀。我們每季分析幾家公司,每家十幾份文件,每份要做的是深度解讀;判斷量小、每個判斷寬、批次執行不需要即時。Jev 設計來每秒做幾十次窄決策,速度與成本從來不是我們的瓶頸。我們讀一篇新聞全文花的 token 比 Jev 貴一千倍,但那一千倍買的是理解。
在整條流程裡,我們找到兩個它能放進去的位置。一個是財報後的候選新聞篩選:887 篇候選裡,它標出 45 篇我們沒選的強偏空文章,其中有幾篇是當時該選而漏掉的觀點文。另一個是抓回全文後的統一標籤:作者立場、消息方向、文章類型,用同一把尺跨公司跨季度標。兩個位置每次合計不到一分錢。這是全部了。
意外的收穫:它比 Claude Opus 5 標得嚴謹
測試裡最有價值的發現,不是關於 Jev 的。
那 12 篇抓回全文的文章,Claude Opus 5 原本的標籤有 6 篇站不住。一篇標題是「AI 建設是否過度依賴 Nvidia 這家銀行」,Opus 5 依標題標成偏空,全文的結尾寫的是「持有 Nvidia 的投資人應該續抱」,Jev 判作者偏多,機率 0.97。一篇講 Adobe 財報後的選擇權交易量,Opus 5 依 put 增加標成偏空,其實是一篇沒有主張的事實報導。另外四篇,Opus 5 把被引述的分析師或執行長的樂觀當成作者的樂觀。
回頭看,Opus 5 的「立場」標籤混了三件事:消息本身的方向、被引述者的立場、作者自己的立場。Jev 的三個問題正好把它們拆開,而且拆得對。它沒有取代分析模型的判斷,但它逼我們把標籤的定義寫清楚。這件事在我們的流程裡已經列為要修的項目。
那它適合誰?
我們的判斷是,四個條件同時成立的場景才值得用:判斷量大、每個題目窄、答案可以從預先給定的選項裡挑、錯一個的代價低或有人接手。符合的例子有:客服工單分部門、內容審核先過一道再送人工、AI agent 每個動作執行前判斷是否具破壞性、幾萬筆商品或文件的批次分類、依請求難度把簡單的送便宜模型。第三方測試裡,有人十分鐘給 98,000 筆商品分類,花兩美分。
📖 Jevons 悖論:資源使用效率提高之後,總用量不減反增的現象,因 Jevons 對 19 世紀英國煤炭消耗的觀察而得名。TypeSafe 把模型命名為 Jev,是在預告:判斷變得幾乎免費之後,軟體裡的判斷次數會暴增。
反過來,需要理解、需要推理、需要知道「哪一邊才對」的工作,不適合。這不是成熟度的問題,是設計上的取捨,它交出了文字生成,換來速度與格式保證。
我們的判斷,以及什麼會推翻它
我們的判斷是:Jev 代表一個真實的新模型類別,它把「軟體裡的窄決策」從大型語言模型手上接過來,速度與成本的優勢在早期獨立測試裡站得住;但它是分流器不是分析師,在需要判斷的工作裡幫助有限。對我們的財報分析,結論是值得知道、暫不接入。
什麼證據會推翻這個判斷?兩個可以驗證的條件。第一,如果新版本在「自己算比率再比較」這類測試上過關,弱點頁裡「不會算數」那條被拿掉,它能進入的步驟會多很多。第二,如果有人在財報文本的立場與類型標籤上,做出比 Claude Opus 5 更一致的結果並公開資料,我們會重新評估把它接進流程。在這兩件事發生之前,我們維持上面的判斷。
一個具體的觀察點:下一次看到「零幻覺」「幾百倍便宜」這類說法,先問參考答案是誰標的。是人,還是另外兩個模型的平均。
參考資料
- TypeSafe AI,Introducing System One Models & Jev,官方發布文
- TypeSafe AI,Jev 1.13 jaggedness,官方模型弱點頁,2026-09-17 版
- Mike(webofmike),I Benchmarked Jev on Agent Tool-Call Risk. Calibration Held.,DEV Community,2026-09-17;程式碼在 jev-benchmark
- Flavio Copes,A deep dive into Jev, TypeSafe's System One model
- Flowtivity,Jev by TypeSafe AI: Is the 200x Faster Decision Model Too Good to Be True?,逐條審核
- awesome-jev,社群整理清單(含 Hacker News 討論串連結)
- 本站測試報告六份與總評估,2026-09-21(本站內部文件,數字皆出自此)
AI 與投資理財知識,持續更新
訂閱後,新文章發布時會寄到你的信箱
我們重視你的隱私,資料不會提供給第三方,隨時可以取消訂閱